Ich kam ja überhaupt nur drauf, weil es mal positiv im Zwei Seiten-Podcast erwähnt wurde, der sonst nur Qualitätsempfehlungen hat. Ansonsten hätte ich es aufgrund des Titels und des allgemeinen Bestseller-Vibes gar nicht angerührt.
Das erste Buch ist ja noch ganz nett. Ein Anwalt tappt aus Versehen in einen kleinen Verbrechensstrudel und alles ist in so ein paar Achtsamkeitsübungen eingebettet. Die gute alte Breaking-Bad-Formel, aber halt nicht so gut. Dafür lässt es sich aber geschmeidig weghören, ist unterhaltsam, ein bisschen spannend und lustig. Außerdem hat Matthias Matschke das sehr gut vorgelesen.
Leider wird das mit jedem weiteren Buch einfach Schritt für Schritt schlechter. Zum einen liest auf einmal der Autor selber, was er zweifellos kann, aber halt nicht so wie Matthias Matschke. Vor allem war man jetzt schon so sehr an ihn gewöhnt und muss dann mitten in der Buchreihe wechseln!
Vor allem die letzten beiden Bände sind einfach nur noch völlig random und quatschig. Da meine Audible-Credits alle waren, ich nach dem dritten aber noch weiterhören wollte, kaufte ich extra neue, um nicht warten zu müssen, und bereute es ein wenig.
Also, nichtsdestotrotz ist es natürlich ganz nett, vor allem am Anfang, aber die letzten beiden Bände kann man getrost weglassen, es passiert nichts Neues mehr.
Abgesehen davon sind die Bücher komplett un-woke und boomermäßig geschrieben, aber darüber konnte ich irgendwie hinwegsehen, weil ich halt dachte: Der Hauptcharakter ist halt ein dämlicher Boomer, okay. Vor allem in den letzten Büchern wurde es aber auch immer anstrengender.
Es gibt ja noch eine Netflix-Serie dazu, in die ich noch nicht reingeschaut habe. Ich hoffe, die haben das Drehbuch dafür stark geändert.
In den letzten Wochen sorgte ich ja dafür, dass alles vernünftig gebackupt wird. Heute widmete ich mich dem letzten Teil – der SSD mit den “großen” Sachen, die nicht in Docker Volumes liegen. Die Hörbücher, Jellyfin, die Paperless-Bibliothek, Immich.
Während ich den Kleinkram direkt per Restic in die Cloud lade, wollte ich diese größeren Sachen erstmal auf die NAS schieben, um sie von dort dann mit ins Online-Backup zu inkludieren. Dabei stieß ich mal wieder auf ein Problem, das ich schon lange vor mir herschiebe: Die NAS ist fast voll. Nur noch gut 200 Gigabyte sind frei.
Dank des Speicherplatz-Analysetools, das so eine DaisyDisk-ähnliche Auswertung generiert, konnte ich herausfinden, was mir die einfache “Die Festplatten sind voll”-Warnung auch schon zeigte: Die Festplatten sind voll. Wer hätte es gedacht.
Natürlich sind es so 5 TB RAWs von der Kamera, jeweils ungefähr 1 TB von den iPhones (Fotos und natürlich hauptsächlich Videos), und der Rest ist Kleinkram, der sich ebenfalls auf weitere 4 TB summiert.
Nichts kann ich wirklich löschen, und die Fotos jetzt auszusortieren wäre auch ein Aufwand, den ich einfach nicht haben will. Auf der anderen Seite würden zwei neue 12-TB-Platten für die beiden leeren Bays auch nochmal 800–900 € kosten. Tjaaa.
Ich hab trotzdem mal das Backup für die wichtigsten Daten eingerichtet. Bei der Jellyfin-Sammlung muss ich halt nochmal schauen. Entweder sichere ich die direkt von der SSD in die Cloud, ohne den Umweg über die NAS, oder ich ignoriere es und muss gegebenenfalls irgendwann ein paar DVDs neu rippen.
Es ist schon wieder ein Freitag mit einem neuen Album. Diesmal von den Monsters of Liedermaching! Ich habe es zum Einschlafen gehört und genau ein Lied geschafft. Ein Review wird also noch warten müssen. Ich weiß noch, dass ich das letzte gar nicht so schlecht fand!
Als ich meine FreshRSS-Instanz auf den Server im Homelab verschob, ging irgendwie die Authentifizierung mit Reeder kaputt und nun habe ich seit zwei Wochen keinen Zugriff auf meine RSS-Feeds, weil ich zu faul war, es zu reparieren.
Ich muss sagen, ich vermisse eigentlich nichts.
Ich habe heute endlich auf Pocket ID umgewechselt. Es war zwar relativ anstrengend, die 8–10 Apps umzustellen, aber es hat sich jetzt schon gelohnt.
Authentik ist einfach langsam. Jeder Auth-Prozess dauerte 3–5 Sekunden. Pocket ID ist einfach instant. Es ist kaum zu glauben. Also klar, ich verliere den alternativen Login über Username/Passwort/TOTP, aber ich bin jetzt auch eh zu 100 % im Passkey-Game.
Ganz davon abgesehen ist Pocket ID auch einfach schön und übersichtlich und toll und alles. Hätte es direkt nehmen sollen.
Des Weiteren gibt es v3 meines kirby-quick-add-Plugins. Nichts Neues, nur Kirby 5 und Dark-Mode-Support. Endlich sieht es nicht mehr so kaputt aus in meinem Panel.
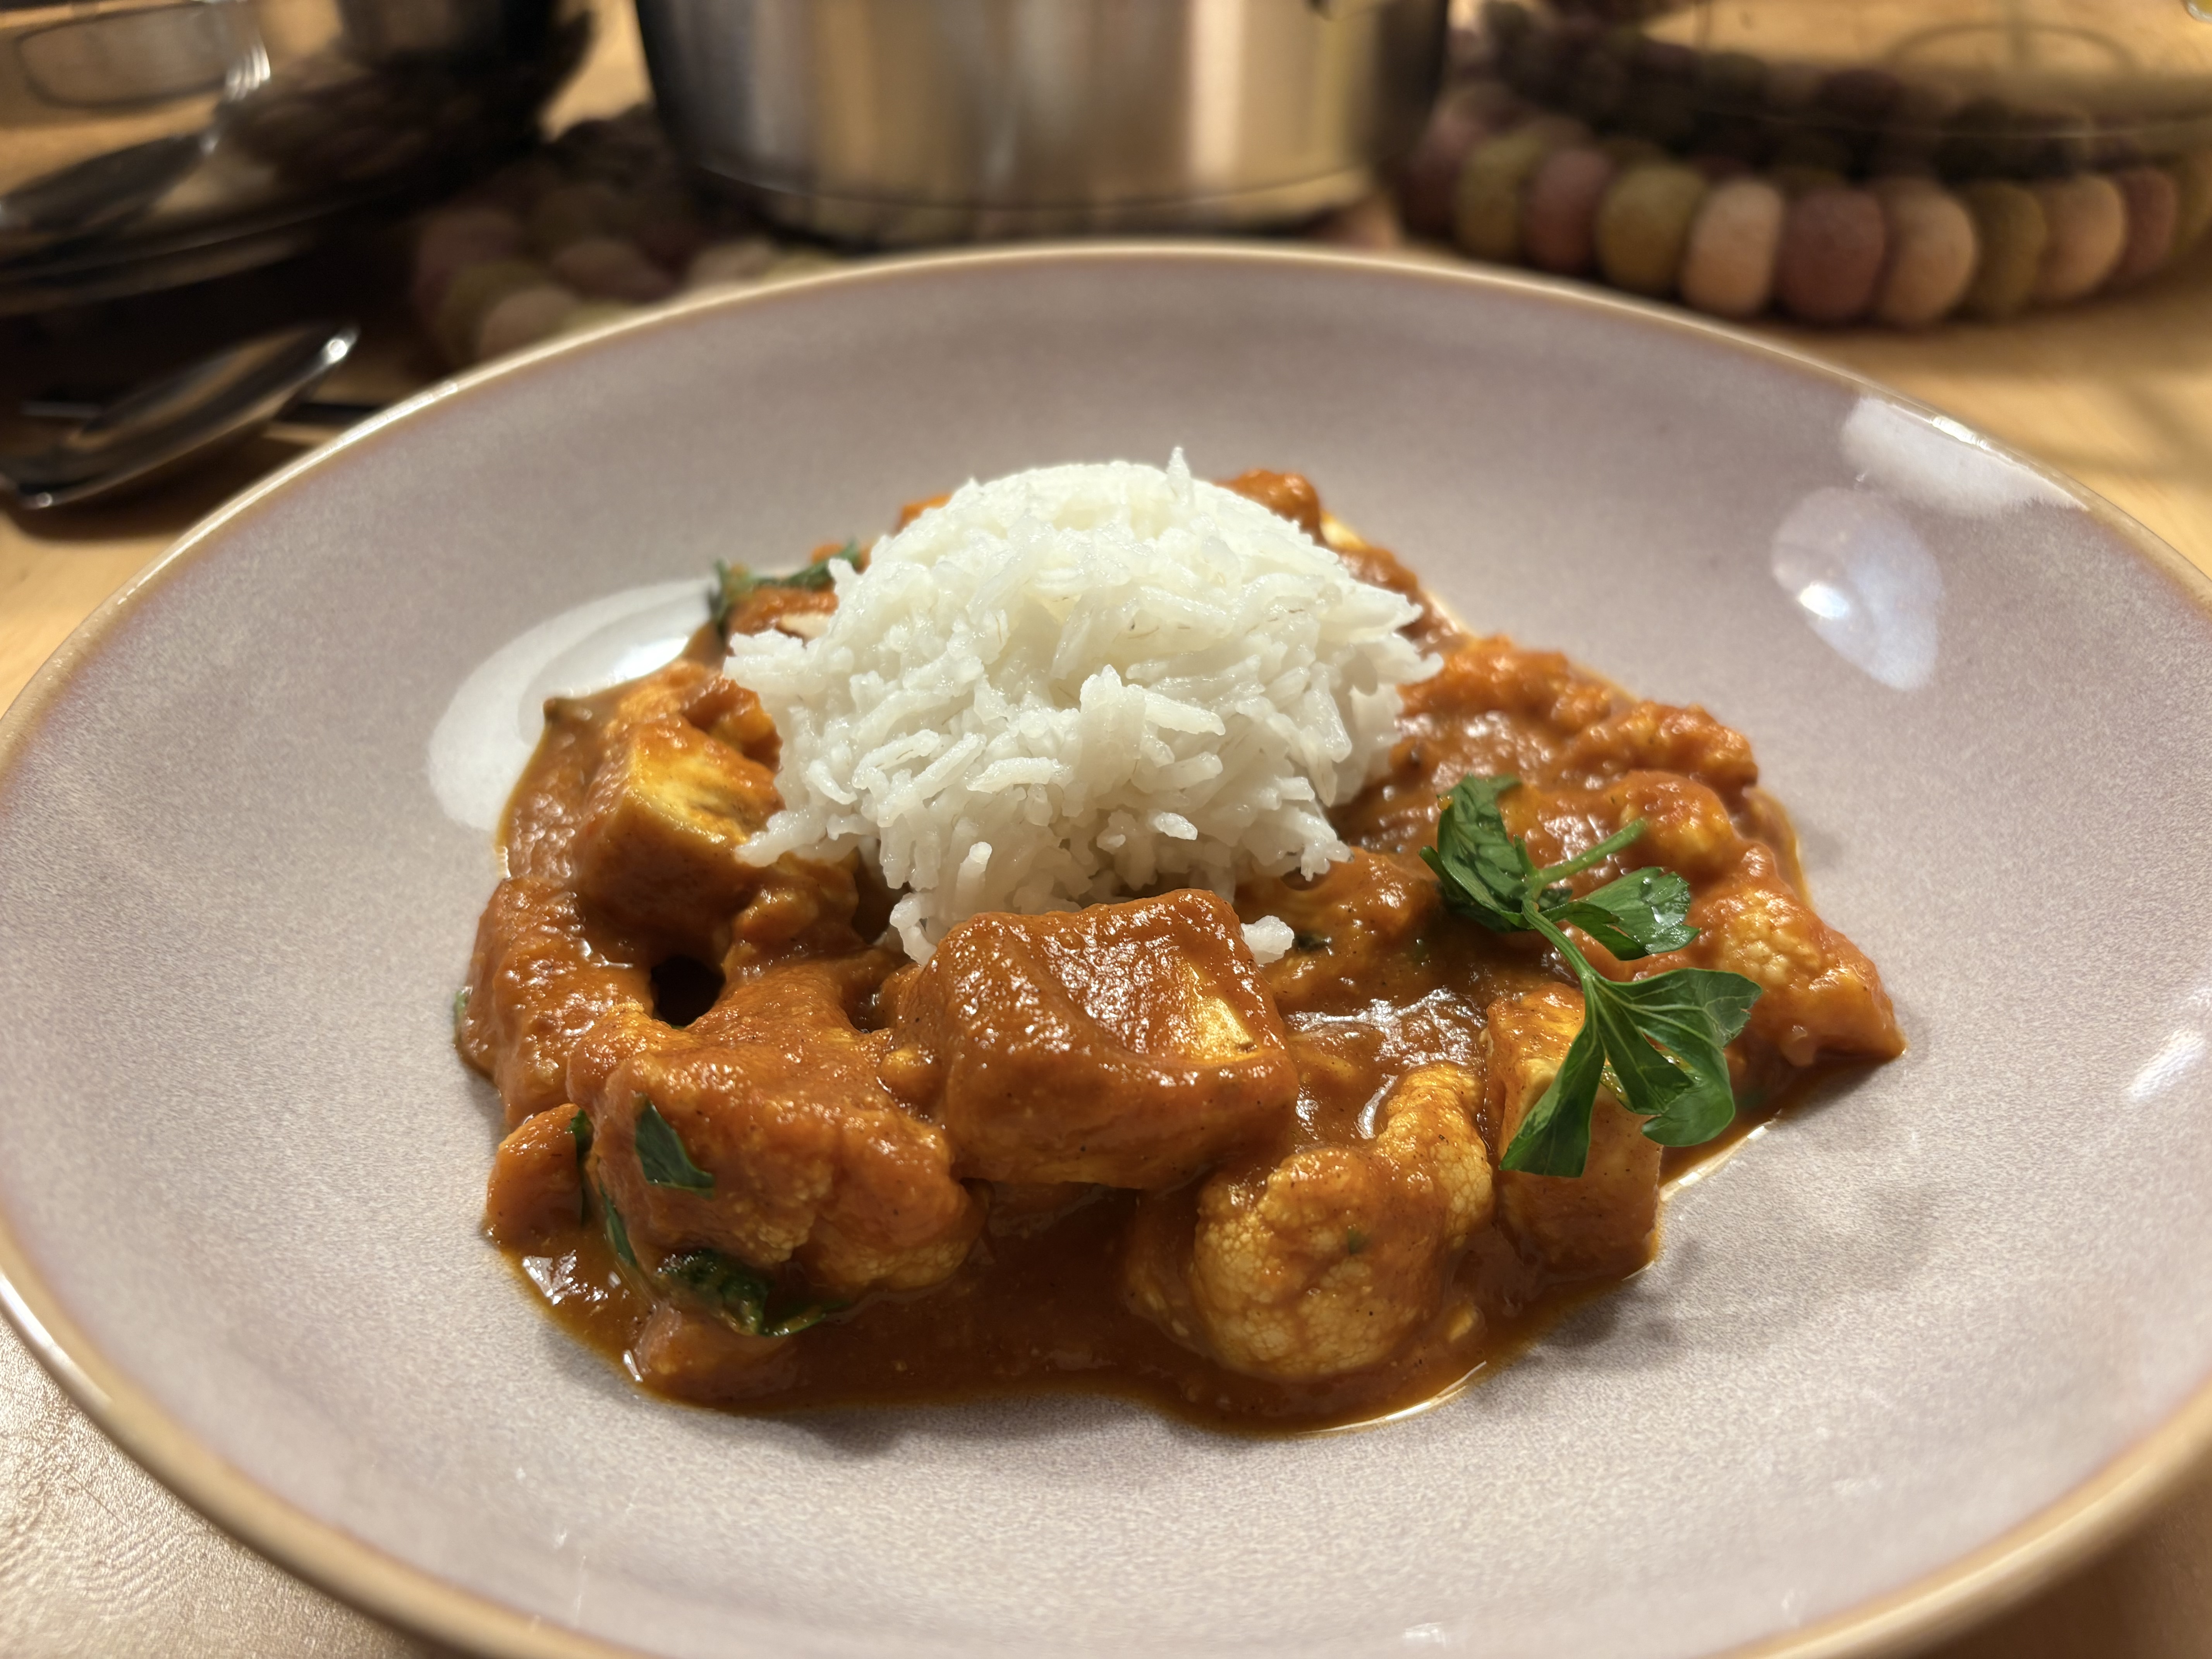
Ich hab heut mal wieder ein Tofu Tikka Masala gemacht. So ohne Currypaste, sondern nur Zwiebeln, Tomaten und eine ganze Wagenladung verschiedener Gewürze. Das macht zwar etwas mehr Arbeit, aber bisher hat es sich immer gelohnt. Man kann etwas herumvariieren und es ist einfach lecker. Außerdem wird es nie zu scharf, wenn man einfach kein Chili reinpackt!
Irgendwann werde ich es auch mal schaffen, etwas davon einzufrieren, aber auch dieses Mal war es wieder zu lecker und musste einfach gegessen werden.
Heute war ich die jährliche Covid-Impfung abholen und es hat fast gar nicht weh getan. Ich weiß ja noch wie schlimm das für mich als Kind war. Jedes Mal muss ich jetzt noch daran denken.
Außerdem habe ich das vierte Achtsam Morden-Buch fertig gehört, weil, naja. Eine Reihe muss beendet werden. Leider war es echt nicht gut und wirkte doch eher für eine Zielgruppe geschrieben, die ich gar nicht bin. Schnell das letzte erschienene hören und ich habe Ruhe vor der Reihe!!
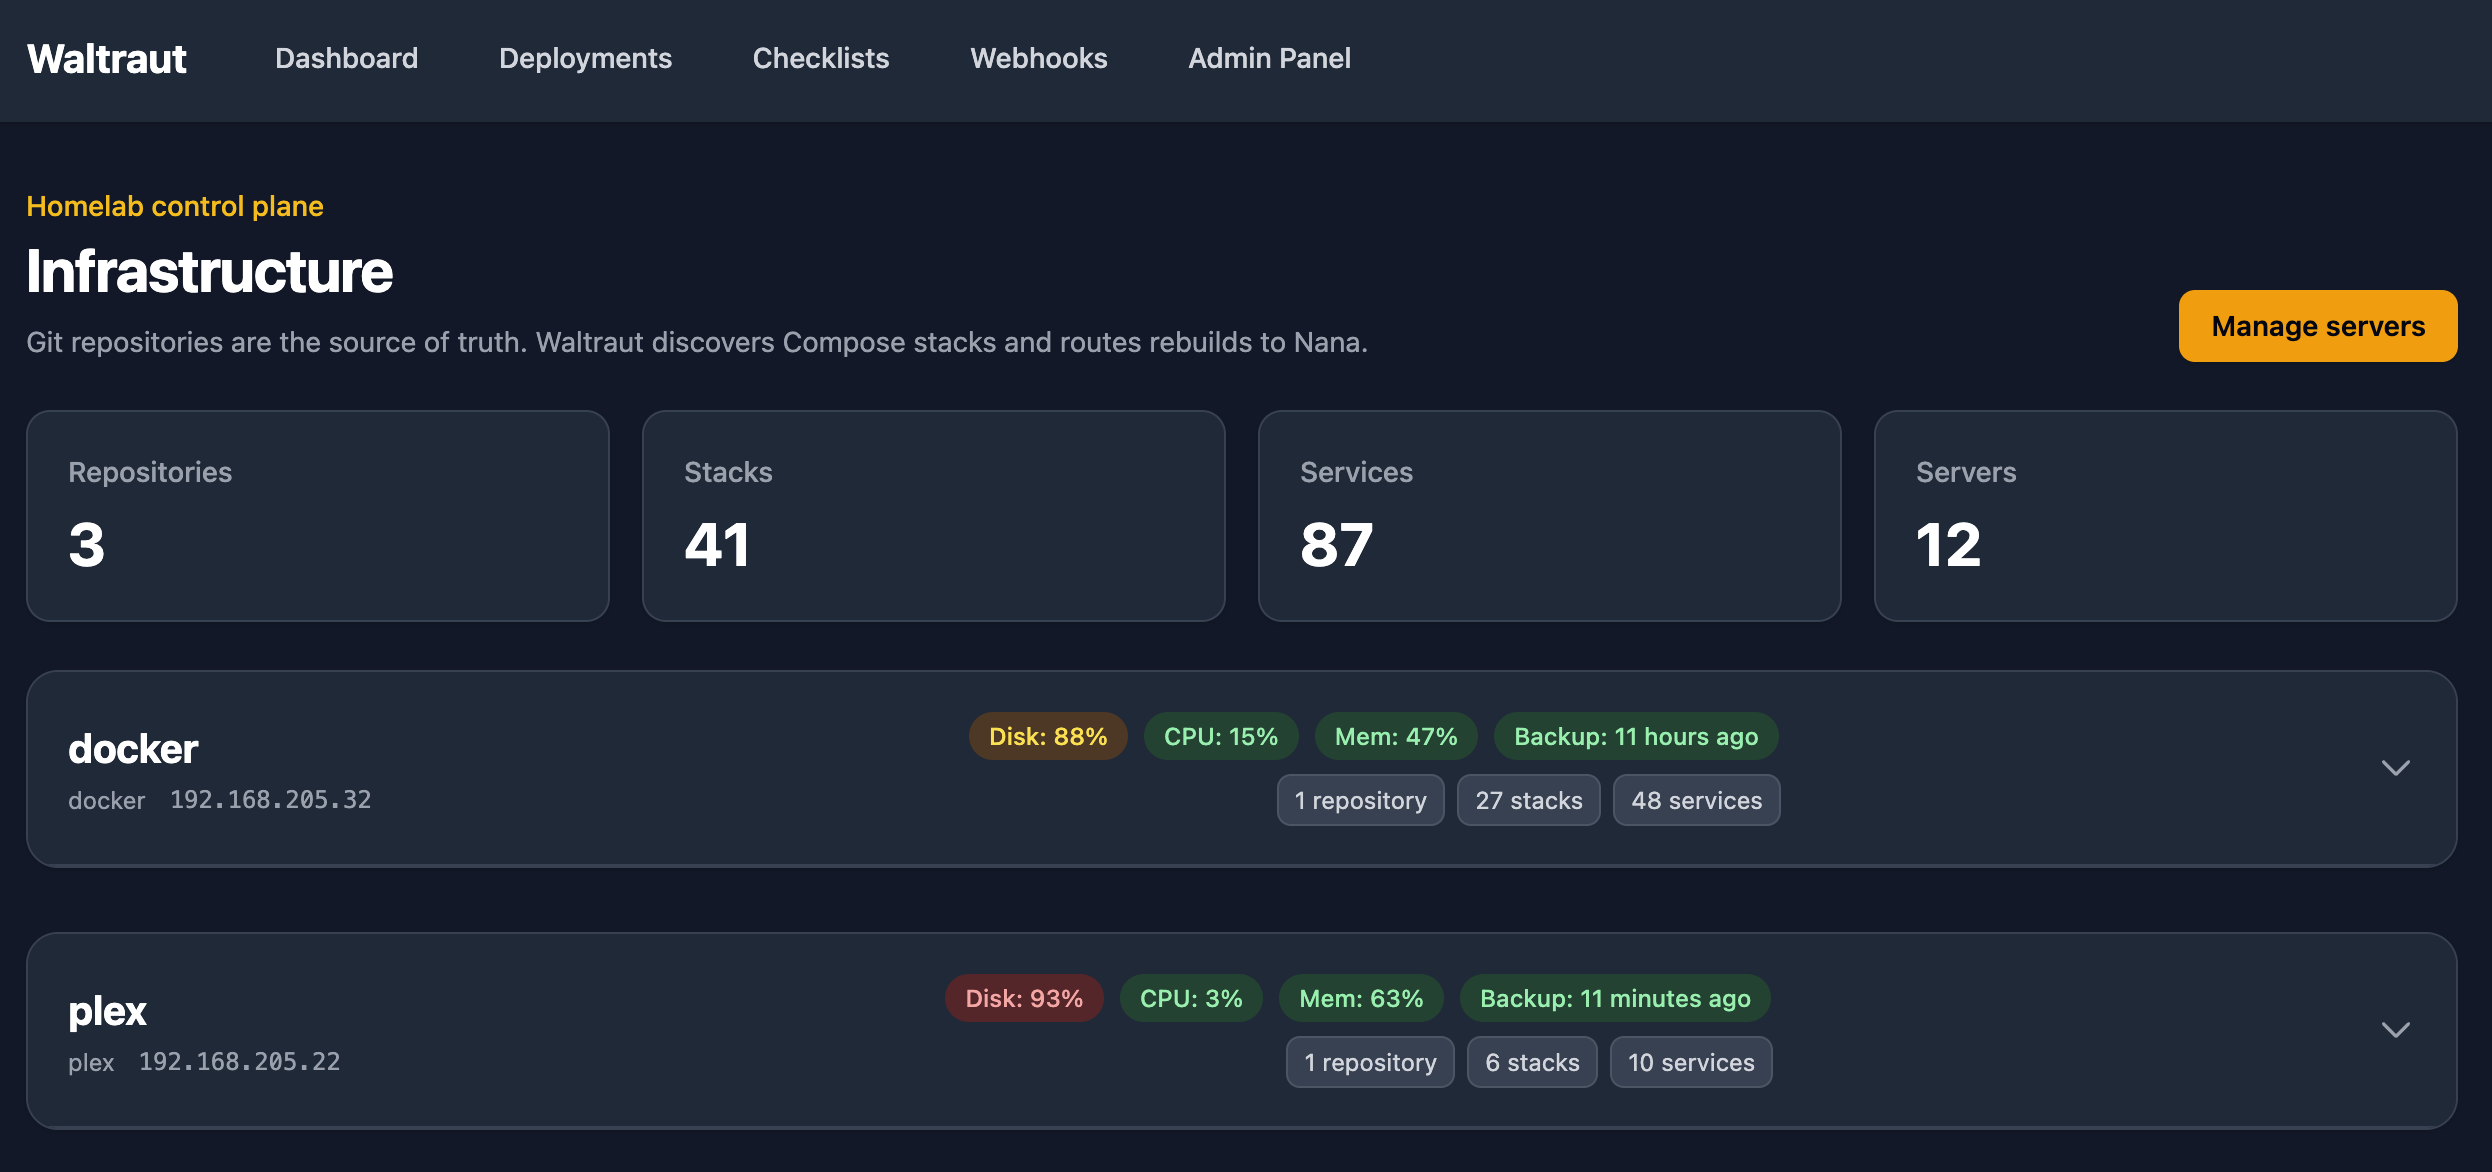
Für zwei von drei Servern habe ich Backups am Laufen und die ganzen Server-Metrics laufen auch wieder rein und waltraut zeigt sie auch wieder an, so langsam formt es sich!
Achtsam morden im Hier und Jetzt
Karsten Dusse
Eindeutig geht es hier bergab in der Reihe. Die letzten 20% des Buches waren gut, der Rest spielt zu sehr damit, von Tantra und Sex handeln zu wollen, hihi wie edgy.
Nachdem ich ein paar Wochen mit einer kaputten Tastatur zu leben versucht hatte, biss ich Anfang Oktober in den sauren Apfel und brachte meinen Mac in die Werkstatt. Mir war klar, dass es ein neues Topcase geben würde und ich danach mindestens 800 € ärmer wäre, aber was soll man machen?
Da ich für die Ausfallzeiten eine Alternative brauchte, installierte ich mir Linux auf einem alten Mini-PC, der noch rumlag. Nach ein bisschen Rumfragen entschied ich mich für Fedora mit KDE.
Folgende Punkte sind mir in der Zeit aufgefallen:
Die Installation lief problemlos, nachdem ich einen passenden USB-Stick gefunden hatte
So ziemlich alles funktionierte einfach out of the Box
Manche Sachen funktionierten auch zu gut: Er fand meine Sonos-Boxen und nutzte sie automatisch für Systemsounds, was ich weder erwartet hatte noch gut fand. Ich fand auf die Schnelle auch keine Möglichkeit, es abzuschalten
Einen „typischen“ Linux-Bug hatte ich: Nach dem Sleep/Suspend funktionierte WLAN nicht mehr. Quickfix: Kabel reinstecken.
Fedora mit KDE bringt seeeeeehr viel Kram mit. Office und so, alles Mögliche. Beim nächsten Mal müsste ich mich mal mehr informieren oder schauen, ob ich beim Installationsprogramm einiges deaktivieren kann.
Kram zu installieren ist etwas verwirrend, da es teilweise mehrere Wege gibt (Snap, Flatpak, Paketmanager) und manche nicht funktionieren. Am Ende hat man drei Wege probiert, mit dem vierten klappt es dann, aber der ganze Müll von den vorherigen Versuchen liegt noch rum.
Insgesamt war es eine ganz gute Experience. Wenn ich müsste, könnte ich wahrscheinlich ganz gut arbeiten; das größte Problem waren allerdings die Tastatur-Shortcuts. Daran gewöhnt man sich in wenigen Stunden einfach nicht.
Mein Körper war zu schwach: Bereits nach einem Tag legte ich auf dem anderen MacBook im Haushalt doch einen Benutzeraccount an und nutzte es teilweise für Dinge.
Ganz unabhängig von Linux war ich überrascht, dass ich außer dem Zugang zu meinem Bitwarden-Vault eigentlich nichts brauche, um arbeitsfähig zu sein.
Fazit: Desktop Linux ist sicher brauchbar, wenn man sich ein paar Tage damit beschäftigt und sein Muscle Memory umstellt. Ich bin trotzdem extrem froh, dass mein MacBook nach drei Tagen wieder fertig war.
Meinen ersten Kindle Paperwhite kaufte ich 2012. Vierzehn Jahre später kaufte ich einen zweiten, diesmal als Geschenk. Ich bin ja Reader-technisch bereits versorgt.
Es ist erstaunlich, wie wenig sich in den Jahren getan hat. Das soll nicht heißen, dass der Paperwhite kein gutes Gerät ist. Das e-Ink-Display sieht toll aus und er fühlt sich echt performant an. Aber es ist einfach kein Sprung, wie man bei einem Abstand von 14 Jahren und 12 Geräte-Generationen vielleicht gedacht hätte.
Damit ist das größte Kaufargument wahrscheinlich der USB-C-Port. Das ist nämlich eigentlich das Einzige, was beim alten Paperwhite wirklich nervte.
Ich habe heut endlich mal die Backups auf allen umgestellten Servern wieder aktiviert. Da hatte ich mich etwas verrannt und mehrfach viel zu komplizierte Sachen gebaut. Auf der einen Seite könnte man das auf die KI schieben, aber andererseits ist mir das früher genau passiert, nur dass ich erst nach einer Woche merkte, dass ich etwas viel zu Komplexes baute und nicht nach 3–4 Prompts.
Nun funktioniert es jedenfalls gut, und alle Datenbanken werden ordentlich gedumpt und nicht nur während der Laufzeit wegkopiert.
Nachdem ich heute morgen noch ein bisschen auf meinem Linux-System gearbeitet habe, bekam ich am Nachmittag den erlösenden Anruf, dass mein Macbook fertig ist. Ich holte es direkt ab und fand mich schnell damit ab, dass es eine sehr teure Reparatur war.
Nun hoffe ich, dass ich wieder ein paar Jahre Ruhe habe, denn auch wenn mein M1 Max vielleicht etwas langsamer ist als eure ganzen M4 und M5-Rechner, bin ich immer noch sehr zufrieden damit!
Ich konnte heute ebenfalls einen ~5€-Server bei Hetzner abschalten, den ich durch meine Infrastruktur-Umbauten arbeitslos machen konnte. Mühsam ernährt sich das Eichhörnchen!
In den letzten Wochen habe ich – ja, gemeinsam mit Claude und Codex – an meinem Deployment im Homelab (und darüber hinaus) gearbeitet. Ursprünglich hatte ich mich ja mit Komodo für eine etablierte Software entschieden, aber nach ein bisschen Rumspielen damit erschien mir das alles zu fett und unübersichtlich. Ich warf es also wieder weg und baute meine eigenen übersichtlichen Skripte.
Jetzt, nachdem ich alle Zahnräder beisammen habe, erinnere ich mich wieder an das völlig überladene und komplizierte UI von Komodo und kann immerhin die ein oder andere Funktion gut nachvollziehen. Alles daran war vielleicht doch nicht übertrieben, ich musste es nur erst einmal nachbauen, um es zu verstehen.
Meine Zahnräder sehen also zusammengefasst so aus:
1) Infra-Repo
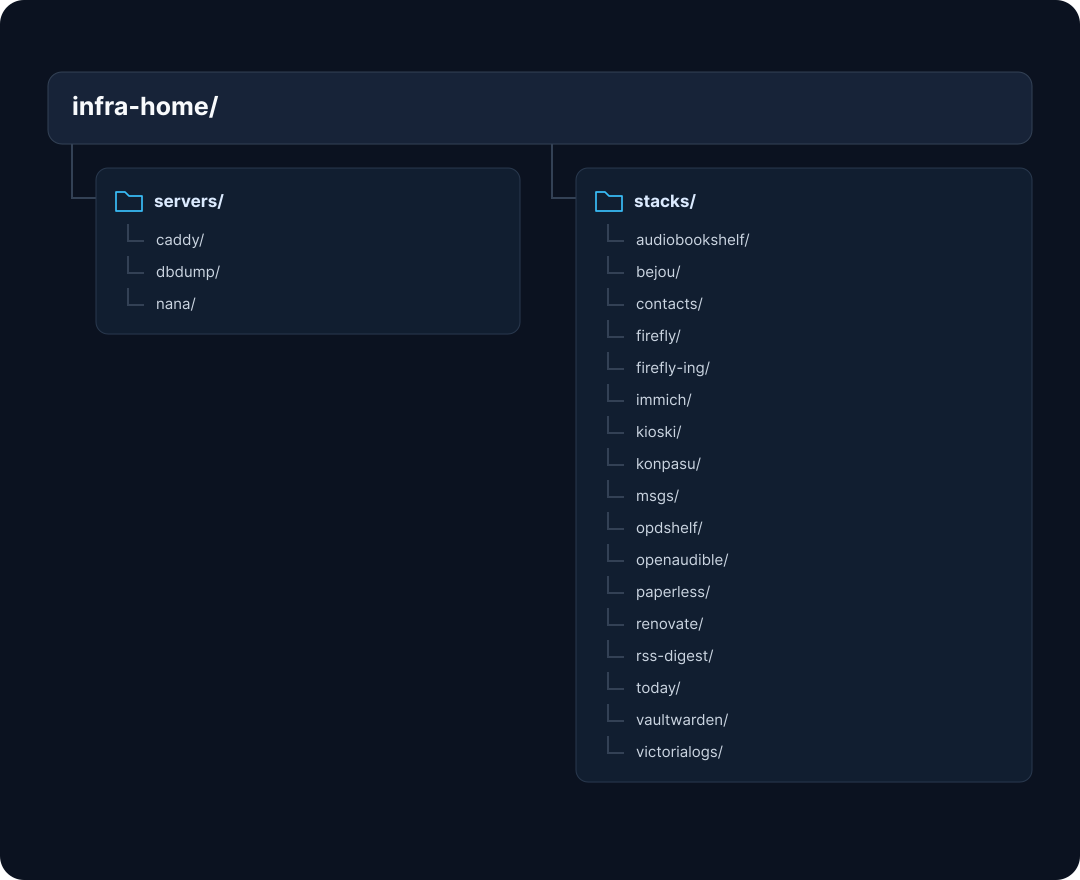
In meinem selbst gehosteten Forgejo habe ich für jeden Server ein Repository, in dem beschrieben ist, was dort alles als Docker-Container läuft. Für zu Hause ist z. B. infra-home. Das besteht aus zwei Teilen:
server/ für die Konfiguration der globalen Sachen – Caddy, der Backup-Service etc.
stacks/ für die einzelnen Stacks. Ein Stack ist dabei jeweils eine compose.yaml, in der die Container beschrieben sind.
Secrets manage ich aktuell noch nicht über git, die werden manuell auf dem Server in .env-Dateien abgelegt, die von der compose.yaml referenziert werden.
2) Woodpecker CI
Ich nutze weiterhin Woodpecker. Wenn ein Infra-Repo gepusht wird, wird hier geschaut, ob alles passt. Es werden ein paar Regeln gecheckt, zum Beispiel, dass ich in den compose.yaml-Dateien keine Secrets direkt reingeschrieben habe und dass ich bei nicht selbstgebauten Containern keine :latest-Tags benutze. (Nervig, aber wer schon mal nach einem random docker compose pull erst mal eine halbe Stunde ein postgres-Update fixen musste, wird es verstehen.)
Diese Überprüfung ist etwas, das ich niemals selbst gebaut hätte, wenn ich alles selbst gemacht hätte – denn wer hat Zeit für so etwas, wenn man sich privat etwas baut? Da die KI das aber einfach für sinnvoll fand, nahm ich das natürlich gerne mit.
3) nana
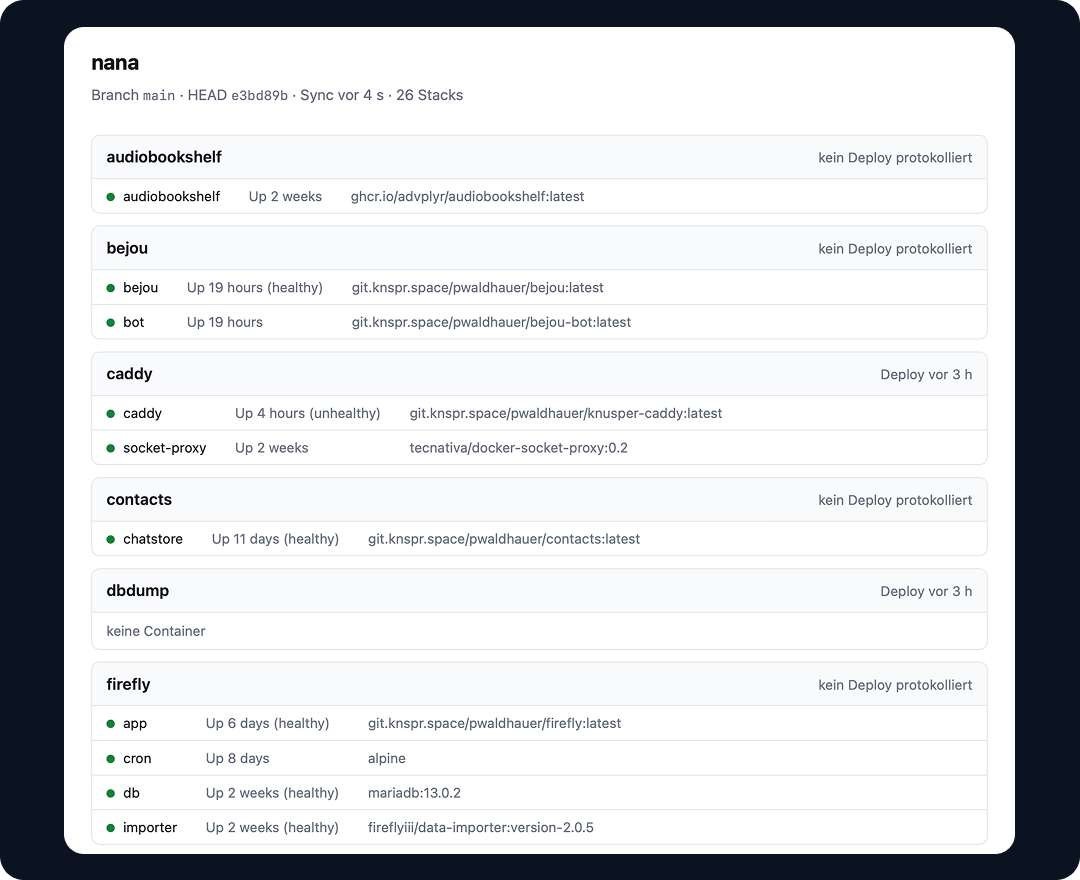
Als ich mich dagegen entschied, Komodo zu verwenden, ließ ich nana bauen. Das ist ein kleiner Daemon, der einfach nur auf einen Webhook reagiert, das Git-Repository neu auscheckt und guckt, in welchen Stacks sich was geändert hat, um diese neu zu starten.
Am Anfang hatte ich also in der .woodpecker.yaml der infra-Repos immer noch einen curl auf den entsprechenden nana-Server.
4) Eigene Services
Natürlich hoste ich ja nicht nur externen Kram, sondern zu einem großen Teil auch selbst entwickelte Sachen. Die sollen natürlich auch entsprechend möglichst leicht ihren Weg auf den Server finden.
Um das zu vereinfachen, habe ich darauf geachtet, dass sich jedes Projekt in der Woodpecker CI zu einem Docker-Container bauen lässt. Egal, ob Node.js-, Go- oder Laravel-Projekt, das Endergebnis ist das gleiche.
Nun stand ich vor einem kleinen Problem: Wie sage ich dem Server, dass er bitte neu deployen soll, sobald das Paket fertig ist, ohne dass ich jedem Projekt mitteilen muss, auf welchem Server es gehostet ist? Also, es braucht ja nur einen curl an Nana, aber an welches?
Um der Pipeline das mitzuteilen, hätte ich es hart in die .woodpecker.yml schreiben müssen oder es über eine Variable in Woodpecker pflegen. Das ist ja aber wirklich Käse.
Ich brauchte also doch noch ein übergreifendes Tool.
5) Waltraut
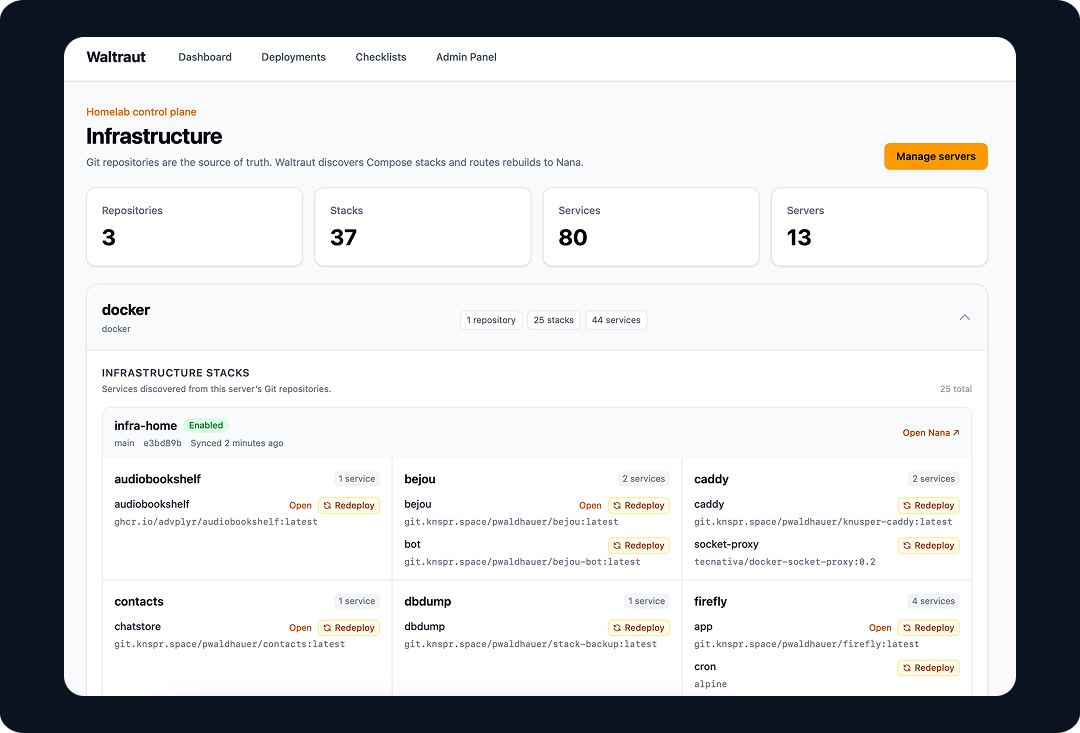
Glücklicherweise hatte ich ja bereits vor Monaten mal eine Laravel-App gebaut, in der ich alle meine laufenden Dienste (manuell) eingetragen habe, die sich zum Beispiel um Health-Checks kümmert und auch Error-Logs über die eingebaute Sentry-Schnittstelle einsammelt.
Statt die Services manuell anzulegen, kann man hier nun also eine URL eines infra-Repos angeben und alles wird automatisch importiert. Zusätzlich kennt Waltraut die URL der entsprechenden nana-Instanz und kann dort klingeln, wenn etwas los ist.
Aber wie bekommt Waltraut nun mit, dass sich etwas verändert? Zum einen bestand die KI darauf, dass es sinnvoll ist, Forgejo einfach alle fünf Minuten zu pollen, falls ein Webhook mal fehlschlägt. Ja, okay.
Da ich auf so etwas allerdings nicht warten kann, ehrlich gesagt, und mir selbst eine Minute Wartezeit bis zum nächsten Poll zu viel wäre, musste natürlich auch der Webhook her.
Ich baute also erst mal in jede .woodpecker.yml einen entsprechenden curl ein, der mitteilte: „Hier, das Image von Projekt foobar ist neu!“ Waltraut schaute dann, auf welchem Server das Image benutzt wird, und sagte der nana-Instanz Bescheid.
Das funktionierte gut, war aber nervig. Ich hasse jede Zeile zu viel in der .woodpecker.yml, vor allem Zeilen, die ich in jedes Projekt reinkopieren muss. Das muss besser gehen.
Irgendwann kam mir die Idee, die globalen Hooks von Forgejo zu benutzen.
Man kann einfach immer dann einen Webhook triggern, wenn ein neues Docker-Image gepusht, also – um in Forgejo-Speak zu bleiben – ein neues Package erstellt wurde. Ich konnte also den ganzen Kram aus der CI-Konfiguration wieder entfernen.
Flow
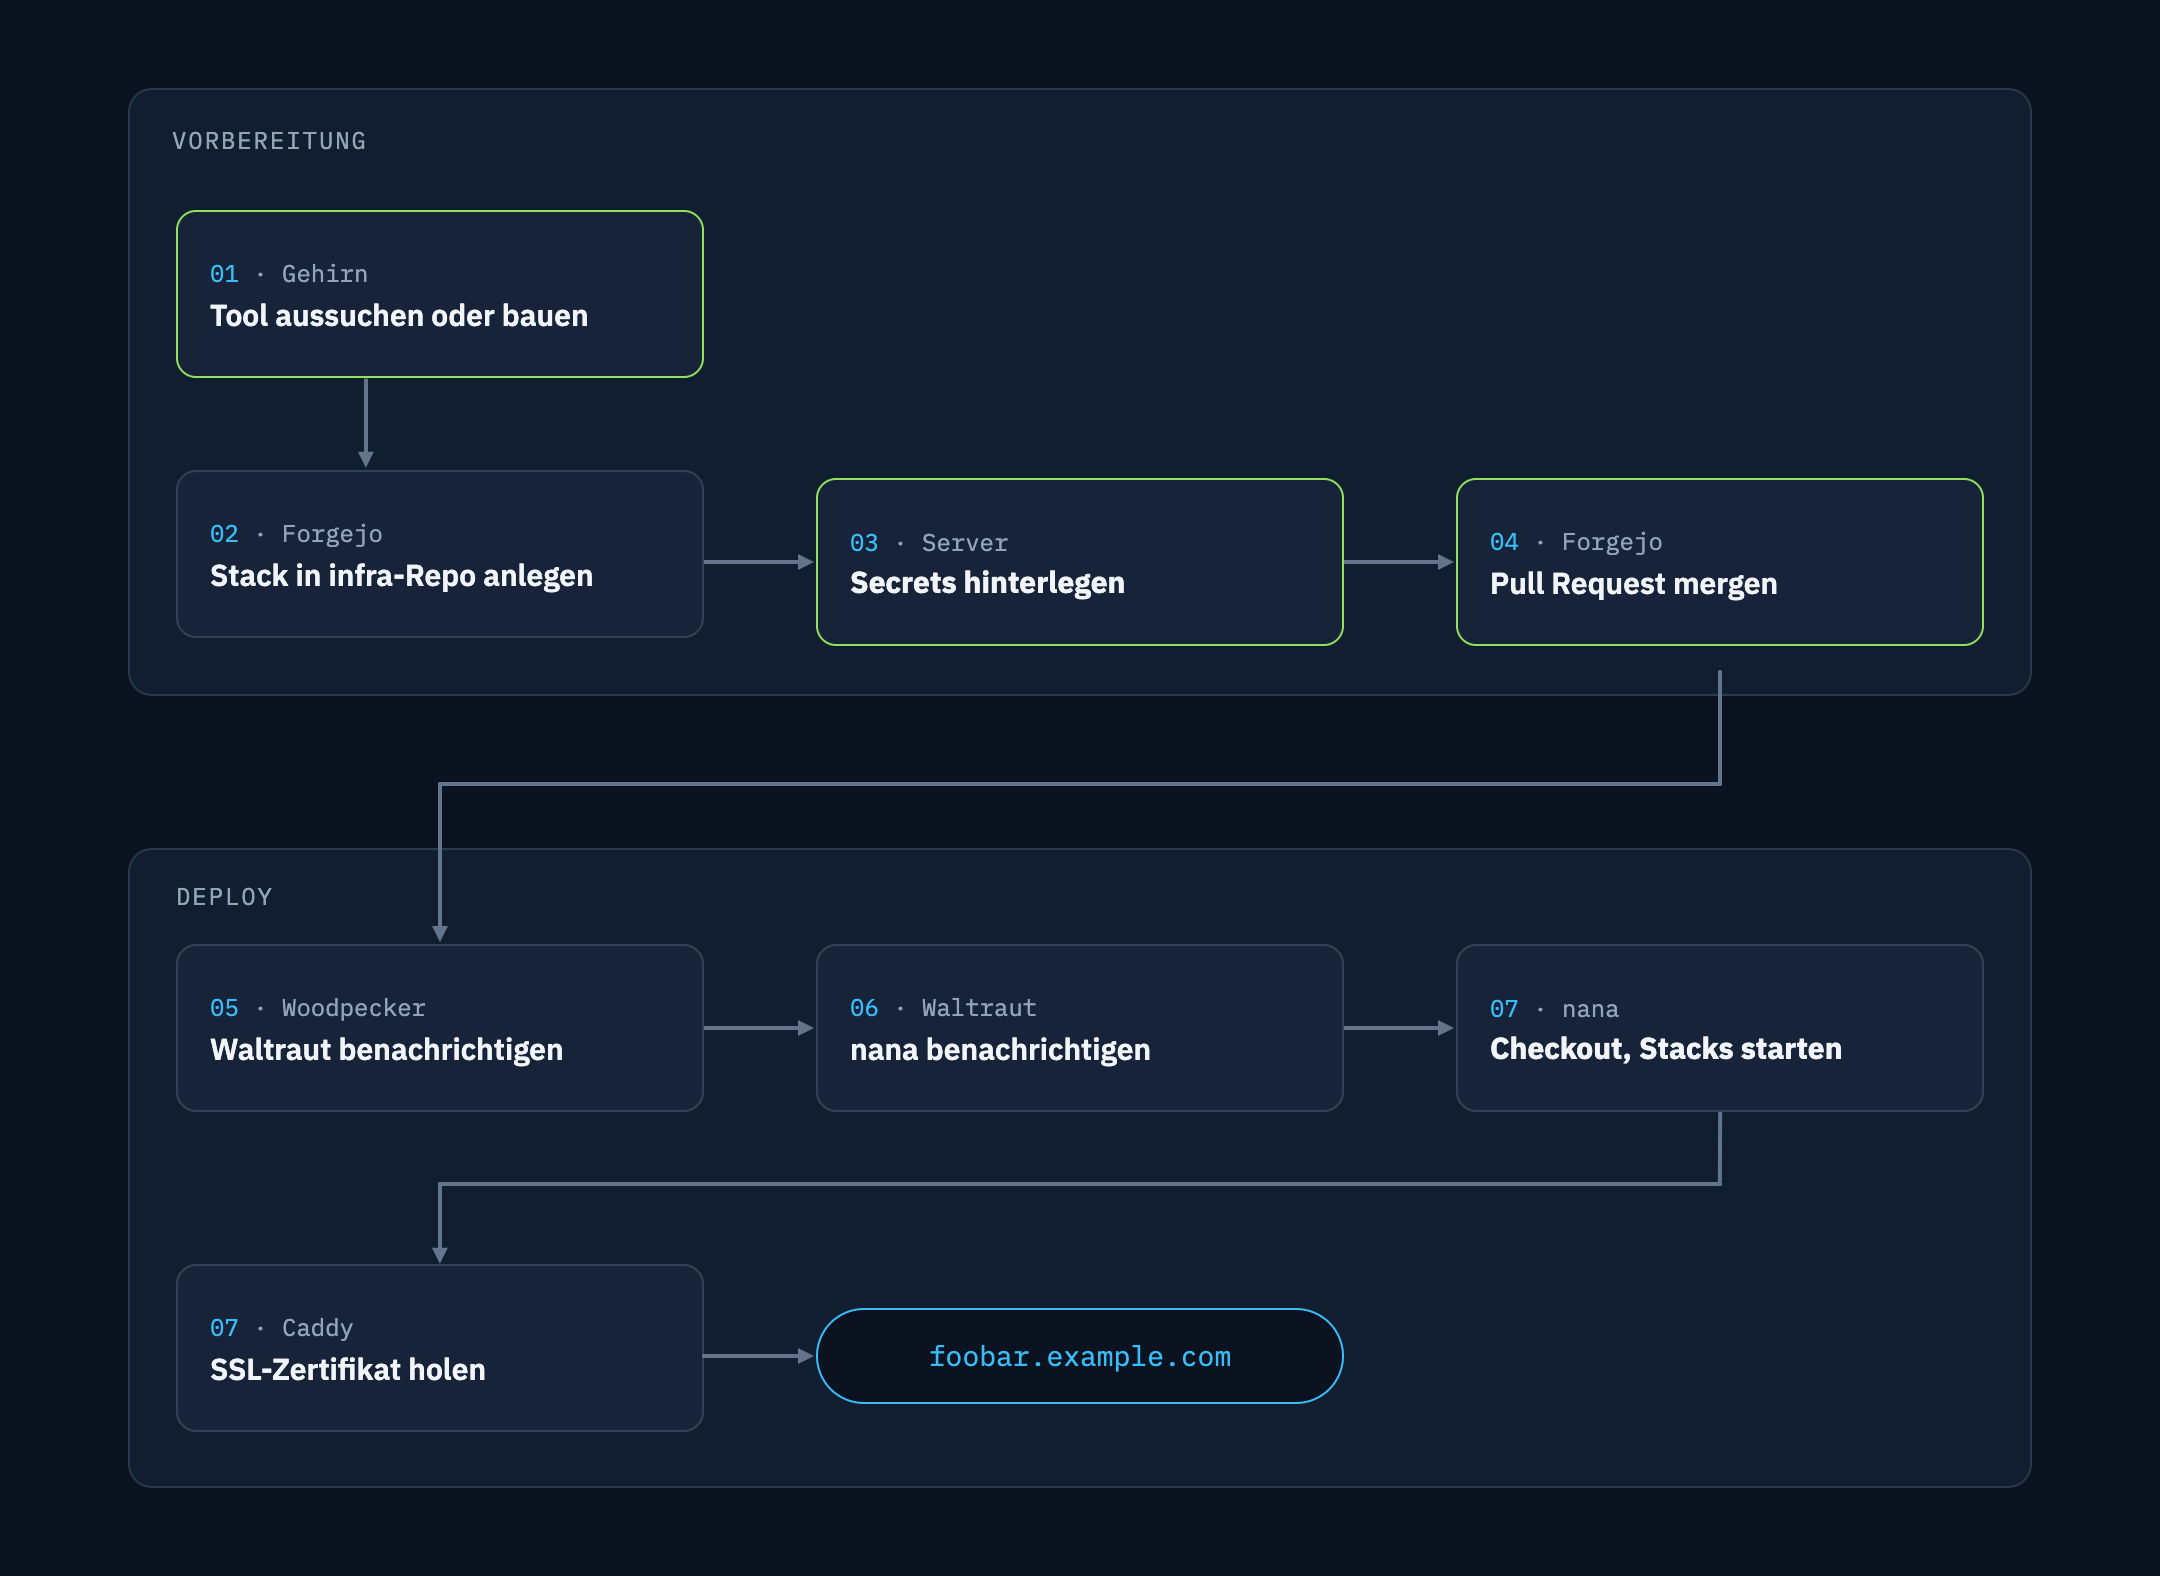
Wenn ich mir nun also überlege, dass ich jetzt Tool XYZ in meinem Homelab installieren will, könnte ich so vorgehen:
Ich sage der KI, dass sie im infra-home-Repo einen Stack für foobar anlegen und mir eine beispielhafte .env-Datei erstellen soll. (Oder mache diesen Schritt, ganz verrückt, manuell)
Ich fülle die .env-Datei aus und speichere sie auf dem Server
Ich merge den Pull Request für das infra-Repo
Woodpecker checkt es und sagt Waltraut Bescheid, dass sich was geändert hat
Waltraut sagt der entsprechenden nana-Instanz Bescheid, die checkt das Repository aus und startet den foobar-Stack
Zwei Minuten später hat Caddy es auch geschafft, ein neues SSL-Zertifikat zu besorgen, und ich kann foobar.example.com aufrufen.
Genauso funktioniert das im Grunde auch für selbst entwickelte Sachen:
Ich sage der KI, dass sie mir bitte Tool XYZ entwickeln und in ein vorgegebenes Git-Repo pushen soll. Oder ich mache es halt selber.
Woodpecker baut das Image und packt es in die Forgejo-Registry
Der Rest ist exakt so wie oben.
Grün: Dinge, die ich noch selber machen muss.
Hätte ich mir jetzt lieber Komodo genauer angucken sollen, statt alles selber zu bauen? Vielleicht wäre das schneller gegangen. So hat es aber mehr Spaß gemacht und mindestens 50 % der Sachen hätte ich eh machen müssen, da man ja auch erst mal alle Projekte dazu kriegen muss, sich korrekt zu verhalten.
Ist meine Lösung production-ready, komplett abgesichert und vor Ausfällen geschützt? Sicherlich nicht, aber da ich 90 % davon sowieso nur zu Hause betreibe und die nana-Instanzen der öffentlichen Server auch nur per Tailscale erreichbar sind, ist das verschmerzbar.
Abgesehen davon kann man über letztere eh nur sagen: „Hier, trigger mal einen Deploy.“ Außer einem DDoS wäre da jetzt auch nicht so viel Angriffspotenzial.
Das Wichtigste an so einem Setup ist ja, dass es übersichtlich und gut dokumentiert ist. Ist ja nicht so, als hätte ich in meinem Webhosting-Leben nicht schon tausende Varianten von automatischen Pipelines in diversen Ausbaustufen gehabt. Meistens ist es so, dass man es entweder nicht fertig baut oder sich nicht merken kann, wie es funktioniert, und vergisst, es zu dokumentieren.
Hier habe ich nun immerhin einen guten Überblick; die Sache ist überschaubar und dank des unermüdlichen Willens der KI sogar dokumentiert. Vor allem das Letzte ist eine Sache, die ich bei privaten Sachen früher natürlich niemals gemacht hätte. Dokumentieren, hahaha.